۱۰ مدل برتر پیشنهادی Hugging Face برای اجرای محلی؛ ویژگیها، GPU مناسب و آموزش Ollama
راهنمای عملی ۱۰ مدل شناختهشده Hugging Face برای اجرای محلی: از Llama و Qwen تا DeepSeek، Gemma، Phi، Granite و Aya؛ همراه با GPU پیشنهادی، نکات VRAM و Quantization، لینک رسمی مدلها و آموزش سریع Ollama، LM Studio و llama.cpp.
مقدمه: «بهترین مدل» بدون توجه به سختافزار معنی ندارد
Hugging Face امروز یکی از مهمترین هابهای مدل، دیتاست و ابزارهای هوش مصنوعی است. اما وقتی هدف ما اجرای محلی مدل روی لپتاپ، ورکاستیشن یا سرور شخصی باشد، سؤال اصلی فقط این نیست که کدام مدل در یک benchmark امتیاز بالاتری گرفته است؛ باید ببینیم چه مدلی با سختافزار ما، زبان مورد نیاز، طول Context، نوع کاربرد و Runtime انتخابی هماهنگ است.
این مقاله ۱۰ مدل شناختهشده و کاربردی را برای Local AI مرور میکند. عبارت «Top 10» در اینجا یک رتبهبندی مطلق علمی نیست؛ این فهرست بر اساس ترکیبی از شهرت، بلوغ اکوسیستم، تنوع کاربرد، دسترسپذیری نسخههای quantized، وجود مسیر اجرای محلی و ارزش آموزشی انتخاب شده است.
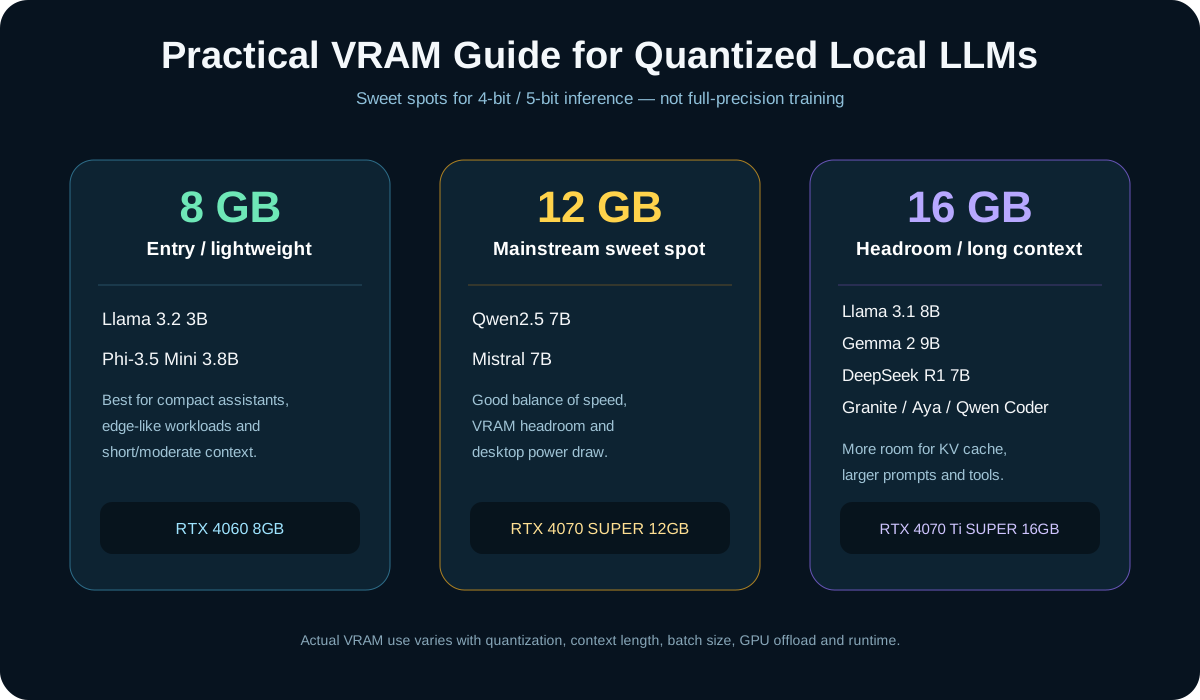
مبنای پیشنهاد GPU در این مقاله: اجرای inference با نسخههای 4-bit یا 5-bit quantized، معمولاً GGUF یا قالب بهینهشده Runtime. برای FP16/BF16 کامل، Fine-tuning یا Training به VRAM بسیار بیشتری نیاز دارید. همچنین Context طولانی، Batch بزرگ و GPU offload روی مصرف حافظه اثر مستقیم دارند.
جدول سریع: ۱۰ مدل و GPU پیشنهادی
| مدل | نقطه قوت اصلی | GPU پیشنهادی عملی | Ollama |
|---|---|---|---|
| Llama 3.1 8B Instruct | عمومی، Agent/Tool، Context بلند | RTX 4070 Ti SUPER 16GB | ollama run llama3.1:8b |
| Llama 3.2 3B Instruct | سبک، سریع، سیستمهای محدود | RTX 4060 8GB | ollama run llama3.2:3b |
| Qwen2.5 7B Instruct | چندزبانه، استدلال، کار روزمره | RTX 4070 SUPER 12GB | ollama run qwen2.5:7b |
| Mistral 7B Instruct v0.3 | سریع، Function Calling، اکوسیستم بالغ | RTX 4070 SUPER 12GB | ollama run mistral:7b |
| Gemma 2 9B IT | کیفیت خوب پاسخ و instruction following | RTX 4080 SUPER 16GB | ollama run gemma2:9b |
| Phi-3.5 Mini Instruct | 3.8B سبک با Context بلند | RTX 4060 8GB | ollama run phi3.5 |
| DeepSeek-R1-Distill-Qwen-7B | Reasoning و مسائل تحلیلی | RTX 4070 Ti SUPER 16GB | ollama run deepseek-r1:7b |
| Granite 3.1 8B Instruct | RAG، Tool Use، Workflow سازمانی | RTX 4070 Ti SUPER 16GB | ollama run granite3.1-dense:8b |
| Aya Expanse 8B | چندزبانه قوی و پشتیبانی از فارسی | RTX 4070 Ti SUPER 16GB | ollama run aya-expanse:8b |
| Qwen2.5-Coder 7B Instruct | تولید، توضیح و اصلاح کد | RTX 4070 Ti SUPER 16GB | ollama run qwen2.5-coder:7b |
این کارتها «حداقل الزام» نیستند؛ هدف، معرفی یک sweet spot کاربردی است. مدلهای 7B/8B با Q4 معمولاً روی VRAM کمتر هم قابل اجرا هستند، اما 12 تا 16 گیگابایت فضای بیشتری برای KV Cache، Context، ابزارها و offload کامل میدهد.
۱. Llama 3.1 8B Instruct — مدل عمومی همهفنحریف
Llama 3.1 8B از Meta یکی از مدلهایی است که اکوسیستم Local AI حول آن بسیار بالغ شده است. مدلکارت رسمی برای نسخه 8B طول Context تا 128K را ذکر میکند و ورودی/خروجی متنی چندزبانه و کد را پوشش میدهد.
مناسب برای: چت عمومی، RAG، خلاصهسازی، Agentهای سبک، ابزارهای داخلی و PoCهای سازمانی.
GPU پیشنهادی: RTX 4070 Ti SUPER با 16GB VRAM. برای Q4 میتوان با 8 تا 12GB هم کار کرد، اما 16GB فضای تنفس بهتری برای Context و GPU offload میدهد.
۲. Llama 3.2 3B Instruct — برای سیستم کوچکتر و latency پایینتر
نسخه 3B خانواده Llama 3.2 حدود 3.21B پارامتر دارد و با وجود اندازه کوچک، مدلکارت رسمی همچنان Context تا 128K را برای خانواده text-only اعلام میکند.
مناسب برای: لپتاپ، سرویسهای کممصرف، دستیار داخلی سبک، edge-like deployment و زمانی که سرعت مهمتر از ظرفیت دانش مدل است.
GPU پیشنهادی: RTX 4060 8GB. در Quantization مناسب حتی سیستمهای ضعیفتر یا Apple Silicon نیز میتوانند تجربه قابل قبولی داشته باشند.
۳. Qwen2.5 7B Instruct — انتخاب بسیار خوب برای چندزبانه و کار روزمره
Qwen2.5 7B Instruct دارای حدود 7.61B پارامتر است. مدلکارت رسمی Context کامل تا 131,072 توکن را مستند میکند، هرچند Runtime یا quantization خاص شما ممکن است Context پیشفرض کوچکتری اعمال کند.
مناسب برای: چت چندزبانه، تولید متن، استخراج ساختیافته، استفاده عمومی و پروژههایی که زبان انگلیسی تنها زبان اصلی نیست.
GPU پیشنهادی: RTX 4070 SUPER 12GB برای نسبت قیمت/سرعت/VRAM مناسب.
۴. Mistral 7B Instruct v0.3 — سریع، ساده و مناسب Tool Use
Mistral 7B Instruct v0.3 یک نسخه instruction-tuned از Mistral 7B است. نسخه v0.3 از tokenizer جدید و Function Calling پشتیبانی میکند و هنوز هم یکی از مدلهای آموزشی خوب برای معماریهای local-first است.
مناسب برای: چت، ابزارهای ساده، API محلی، workflowهای سبک و پروژههایی که latency پایین مهم است.
GPU پیشنهادی: RTX 4070 SUPER 12GB.
۵. Gemma 2 9B IT — کیفیت خوب در کلاس زیر ۱۰B
Gemma 2 9B IT از Google برای instruction following و گفتوگو انتخاب شناختهشدهای است. نسبت به مدلهای 7B کمی سنگینتر است و برای اجرای روان local بهتر است VRAM بیشتری در نظر بگیرید.
مناسب برای: پاسخهای عمومی باکیفیت، خلاصهسازی، تولید متن و آزمایش مدلهای خانواده Gemma.
GPU پیشنهادی: RTX 4080 SUPER 16GB. مدل quantized روی کارتهای ضعیفتر هم اجرا میشود، ولی 16GB برای 9B انتخاب راحتتری است.
۶. Phi-3.5 Mini Instruct — کوچک اما جدی
Phi-3.5 Mini از Microsoft فقط حدود 3.8B پارامتر دارد و مدلکارت رسمی Context 128K را ذکر میکند. این ترکیب باعث میشود برای سیستمهایی با بودجه سختافزاری محدود جذاب باشد.
مناسب برای: دستیار سبک، خلاصهسازی، RAG کوچک، پردازش سند و سیستمهایی که مدل 7B/8B بیش از حد سنگین است.
GPU پیشنهادی: RTX 4060 8GB.
۷. DeepSeek-R1-Distill-Qwen-7B — Reasoning روی سختافزار شخصی
این مدل نسخه Distill از خانواده DeepSeek-R1 است که بر پایه Qwen2.5-Math-7B ساخته شده و برای reasoning، ریاضی و پاسخهای تحلیلی جذاب است. خروجی reasoning معمولاً توکن بیشتری مصرف میکند؛ بنابراین VRAM و Context headroom نسبت به چت ساده مهمتر میشود.
مناسب برای: تحلیل مرحلهای، حل مسئله، ریاضی، آزمایش reasoning محلی و Agentهای تحلیلی.
GPU پیشنهادی: RTX 4070 Ti SUPER 16GB.
۸. Granite 3.1 8B Instruct — برای RAG و Workflow سازمانی
IBM Granite 3.1 8B یک مدل dense حدود 8.1B است. مستندات خانواده Granite روی RAG، استخراج متن، Question Answering، Code-related tasks و Function Calling تأکید دارند و طول sequence تا 128K نیز برای خانواده 3.1 مستند شده است.
مناسب برای: سامانههای سازمانی، RAG، ابزارها، طبقهبندی/استخراج و backendهای داخلی.
GPU پیشنهادی: RTX 4070 Ti SUPER 16GB.
۹. Aya Expanse 8B — انتخاب جذاب برای فارسی و چندزبانه
Aya Expanse 8B از Cohere Labs یک مدل open-weight چندزبانه است و مدلکارت رسمی ۲۳ زبان را فهرست میکند که Persian نیز در میان آنهاست.
این ویژگی Aya را برای تست سناریوهای فارسی، ترجمه، پاسخ چندزبانه و مقایسه با مدلهایی که تمرکز اصلیشان انگلیسی است جذاب میکند.
GPU پیشنهادی: RTX 4070 Ti SUPER 16GB.
نکته مجوز: مدل با مجوز CC-BY-NC و شرایط استفاده Cohere Labs عرضه میشود؛ برای کاربرد تجاری حتماً مجوز را جداگانه بررسی کنید.
۱۰. Qwen2.5-Coder 7B Instruct — مدل تخصصی برنامهنویسی
Qwen2.5-Coder 7B برای Code Generation، Code Reasoning و Code Fixing طراحی شده است. مدلکارت Hugging Face تا 128K context را برای این مدل ذکر میکند؛ در مقابل، package فعلی 7B در Ollama ممکن است Context پیشفرض کوچکتری مانند 32K ارائه کند، بنابراین همیشه تنظیم Runtime را نیز بررسی کنید.
مناسب برای: تولید کد، توضیح کد، refactor، رفع خطا، ساخت prototype و دستیار local برای IDE.
GPU پیشنهادی: RTX 4070 Ti SUPER 16GB، مخصوصاً اگر repository context یا promptهای طولانی استفاده میکنید.
VRAM دقیقاً کجا مصرف میشود؟
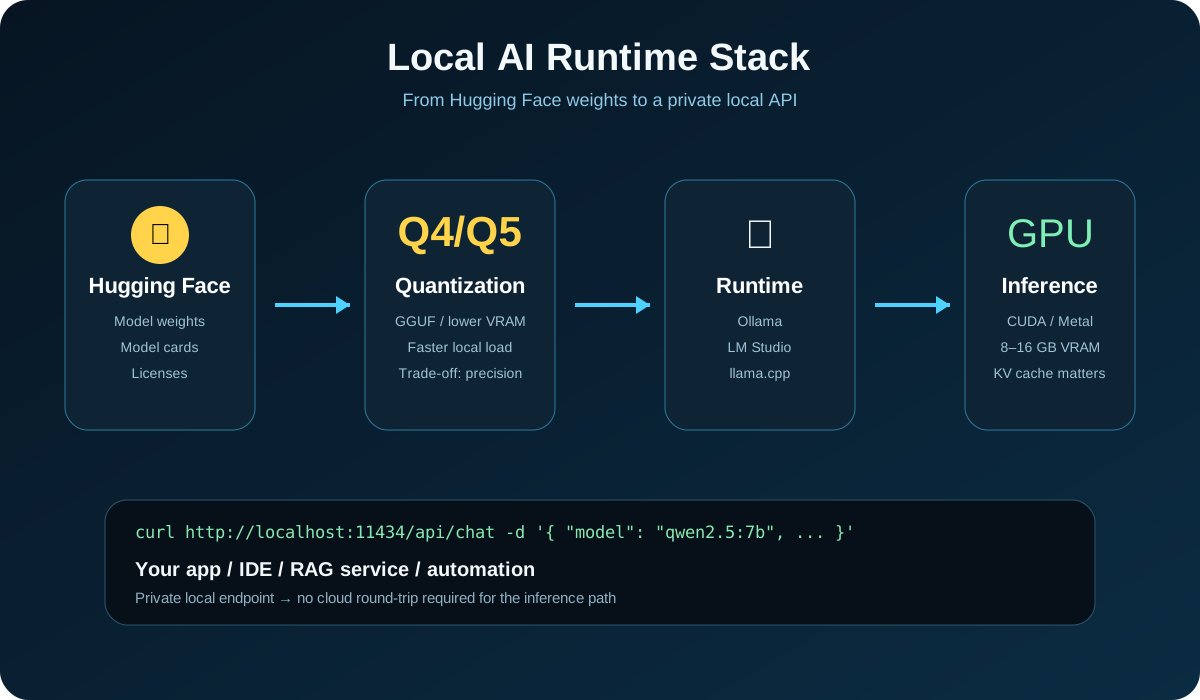
حافظه GPU فقط برای وزنهای مدل نیست. چهار مصرفکننده مهم عبارتاند از:
- Model Weights: Quantization از FP16 به Q4/Q5 حجم وزنها را به شکل محسوسی کاهش میدهد.
- KV Cache: هرچه Context بلندتر باشد، حافظه بیشتری برای attention cache لازم میشود.
- Runtime Buffers: Ollama، llama.cpp، CUDA و backendهای مختلف bufferهای خود را دارند.
- Concurrent Requests / Batch: اگر همزمان چند درخواست داشته باشید، مصرف حافظه افزایش پیدا میکند.
بنابراین جمله «مدل 7B روی 8GB اجرا میشود» همیشه به معنی «با Context بسیار بلند و چند کاربر همزمان هم عالی اجرا میشود» نیست.
Quantization: چرا Q4 برای Local AI مهم است؟
مدلهای Hugging Face معمولاً با وزنهای اصلی Safetensors منتشر میشوند. برای اجرای محلی روی سختافزار مصرفی، نسخههای GGUF quantized بسیار محبوباند.
بهصورت ساده:
- Q4: حافظه کمتر و سرعت خوب؛ نقطه شروع مناسب برای اکثر کاربران.
- Q5: کیفیت کمی بهتر با مصرف حافظه بیشتر.
- Q8: نزدیکتر به وزنهای اصلی، اما سنگینتر.
- FP16/BF16: برای inference کامل یا کارهای توسعهای سنگین؛ به VRAM بسیار بیشتری نیاز دارد.
هیچ Quantization «بهترین مطلق» نیست؛ باید کیفیت خروجی، سرعت و حافظه را با workload واقعی خودتان بسنجید.
آموزش سریع Ollama
Ollama یکی از سادهترین راهها برای اجرای مدلهای محلی روی Windows، Linux و macOS است.
۱. نصب Ollama
دانلود رسمی:
در Linux میتوانید از installer رسمی استفاده کنید:
curl -fsSL https://ollama.com/install.sh | sh
۲. اجرای اولین مدل
برای Llama:
ollama run llama3.1:8b
برای Qwen:
ollama run qwen2.5:7b
برای مدل Reasoning:
ollama run deepseek-r1:7b
برای برنامهنویسی:
ollama run qwen2.5-coder:7b
Ollama در اولین اجرا مدل را دانلود میکند و سپس یک prompt تعاملی محلی در اختیار شما میگذارد.
کتابخانه رسمی مدلها:
۳. استفاده از Ollama بهعنوان API
Ollama بهصورت پیشفرض API محلی ارائه میدهد. نمونه:
curl http://localhost:11434/api/chat \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen2.5:7b",
    "messages": [
      {"role": "user", "content": "سه کاربرد عملی RAG را توضیح بده"}
    ],
    "stream": false
  }'
این یعنی میتوانید backend پایتون، Django، Node.js، workflow اتوماسیون یا حتی ابزارهای داخلی شرکت را به مدل محلی متصل کنید.
۴. مدیریت مدلها
ollama list
ollama pull phi3.5
ollama rm phi3.5
گزینه دوم: LM Studio برای رابط گرافیکی
اگر CLI نمیخواهید، LM Studio گزینه بسیار خوبی برای دانلود و اجرای مدلهای GGUF است. رابط Chat، Model Discovery و API محلی دارد.
برای کاربر دسکتاپی که میخواهد بدون درگیری با command line چند quantization مختلف را مقایسه کند، LM Studio تجربه بسیار راحتی دارد.
گزینه سوم: llama.cpp برای کنترل پایینسطحتر
llama.cpp پایه بسیاری از ابزارهای Local LLM است و برای GGUF، اجرای CPU/GPU hybrid و ساخت server محلی بسیار محبوب است.
نمونه اجرای مستقیم یک GGUF:
llama-cli -m ./model.gguf -p "Explain vector databases in five bullet points."
و برای API سازگار با OpenAI-style workflows میتوانید از server آن استفاده کنید.
NVIDIA، AMD یا Apple Silicon؟
برای Windows/Linux، کارتهای NVIDIA معمولاً کمدردسرترین مسیر برای اکوسیستم CUDA هستند. AMD نیز بسته به Runtime و سیستمعامل قابل استفاده است، اما compatibility را برای مدل و backend خود بررسی کنید. روی macOS، Apple Silicon با unified memory میتواند تجربه بسیار خوبی برای Local AI ایجاد کند و معیار مقایسه آن با VRAM کارتهای مجزا دقیقاً یکسان نیست.
کدام مدل را انتخاب کنم؟
اگر فقط یک مدل عمومی میخواهید، Llama 3.1 8B یا Qwen2.5 7B نقطه شروع خوبی هستند.
اگر GPU ضعیفتری دارید، Llama 3.2 3B و Phi-3.5 Mini منطقیترند.
اگر فارسی و چندزبانه مهم است، Aya Expanse 8B و Qwen2.5 7B ارزش تست بیشتری دارند.
اگر برنامهنویسی هدف اصلی است، Qwen2.5-Coder 7B را امتحان کنید.
اگر reasoning مهمتر از سرعت چت است، DeepSeek-R1-Distill-Qwen-7B انتخاب جذابی است.
و اگر معماری RAG/Tool/Workflow سازمانی دارید، Granite 3.1 8B ارزش بررسی دارد.
چکلیست قبل از دانلود
- مجوز مدل را بخوانید؛ open-weight الزاماً به معنی مجوز تجاری بدون محدودیت نیست.
- مقدار VRAM/RAM و فضای دیسک را بررسی کنید.
- نسخه quantized و سطح Q مناسب را انتخاب کنید.
- Context را بیدلیل روی حداکثر قرار ندهید؛ KV Cache هزینه دارد.
- مدل را با داده و زبان واقعی پروژه خودتان benchmark کنید.
- برای اطلاعات حساس، مسیر ذخیره prompt/log و telemetry ابزار را بررسی کنید.
جمعبندی
اجرای محلی LLM دیگر محدود به سرورهای چند-GPU نیست. مدلهای 3B تا 9B با Quantization مناسب میتوانند روی یک سیستم دسکتاپ قدرتمند یا حتی سختافزار سبکتر تجربه مفیدی ارائه دهند.
اما انتخاب درست از خود مدل مهمتر است: کاربرد، زبان، Context، VRAM، Runtime و مجوز باید با هم دیده شوند. برای شروع سریع، Ollama سادهترین مسیر است؛ LM Studio رابط گرافیکی قدرتمندی ارائه میدهد و llama.cpp کنترل بیشتری در سطح runtime در اختیار توسعهدهنده میگذارد.
نظرات
در حال بارگذاری نظرات...